Depois de anos de corrida por modelos de linguagem cada vez maiores e mais generalistas, empresas de setores críticos como saúde, direito e finanças estão migrando para uma lógica inversa: modelos menores, treinados exclusivamente com dados do próprio domínio, que entregam menos “alucinações” e mais precisão onde o erro não pode acontecer
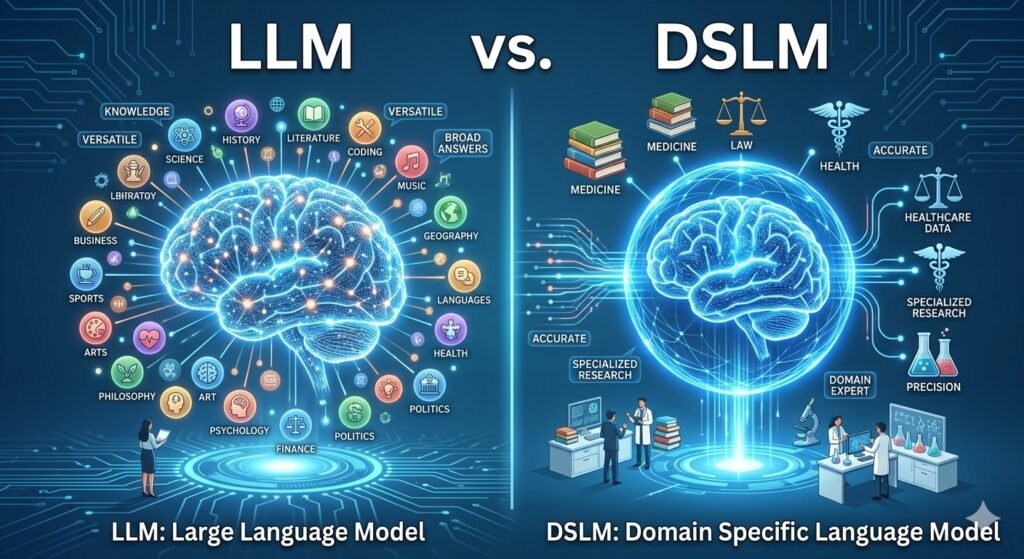
Durante anos, a corrida da inteligência artificial seguiu uma lógica simples: quanto maior o modelo, mais dados ele processa durante o treinamento, mais capaz ele deveria ser. Essa lógica resultou nos chamados LLMs (Large Language Models, ou Grandes Modelos de Linguagem) — sistemas generalistas, treinados com volumes gigantescos de dados da internet, capazes de responder sobre praticamente qualquer assunto, de receitas de bolo a equações de física quântica.
Só que, em setores onde o erro tem um custo alto demais para ser tolerado, essa generalidade começou a se mostrar um problema, e não uma vantagem. É nesse contexto que ganham força os DSLMs (Domain-Specific Language Models, ou Modelos de Linguagem Específicos de Domínio): sistemas de inteligência artificial treinados, desde o início ou por ajuste fino, exclusivamente com dados de um setor específico — prontuários médicos, jurisprudência, contratos financeiros, normas regulatórias — em vez de absorver um pouco de tudo que existe disponível na internet.
A diferença prática entre um LLM e um DSLM
A diferença entre os dois tipos de modelo não está necessariamente no tamanho (embora DSLMs costumem ser menores), mas sim na profundidade e na origem dos dados usados no treinamento. Um LLM generalista aprendeu um pouco sobre medicina, um pouco sobre direito, um pouco sobre finanças, misturado com literatura, notícias, fóruns de internet e praticamente qualquer outro tipo de texto disponível publicamente. Já um DSLM é construído especificamente para “viver” dentro de um único universo de conhecimento: ele entende a terminologia técnica, as normas regulatórias, o histórico de casos e os riscos específicos daquela área, porque foi treinado quase exclusivamente com esse tipo de material.
Na prática, isso significa que um gestor de saúde que usa um DSLM obtém respostas alinhadas a prontuários reais e termos clínicos específicos, em vez de respostas genéricas que soam corretas, mas que não refletem exatamente o vocabulário e os protocolos daquele hospital ou daquela especialidade. O mesmo vale para um profissional de finanças, que precisa de precisão absoluta ao interpretar políticas internas, classificações de risco e documentos regulatórios — um contexto onde uma resposta “quase certa” de um modelo generalista pode gerar um problema real.
Por que isso reduz as famosas “alucinações” da IA
Um dos problemas mais conhecidos dos modelos de linguagem generalistas é a chamada alucinação: o modelo gera uma resposta com aparência de segura e correta, mas que, na verdade, é factualmente errada ou simplesmente inventada. Isso acontece, em boa parte, porque um modelo generalista tenta “preencher lacunas” de conhecimento combinando padrões aprendidos de contextos muito diferentes entre si — e, quanto mais amplo e diverso for o material de treinamento, maior a chance de o modelo misturar informações de domínios que não deveriam se misturar.
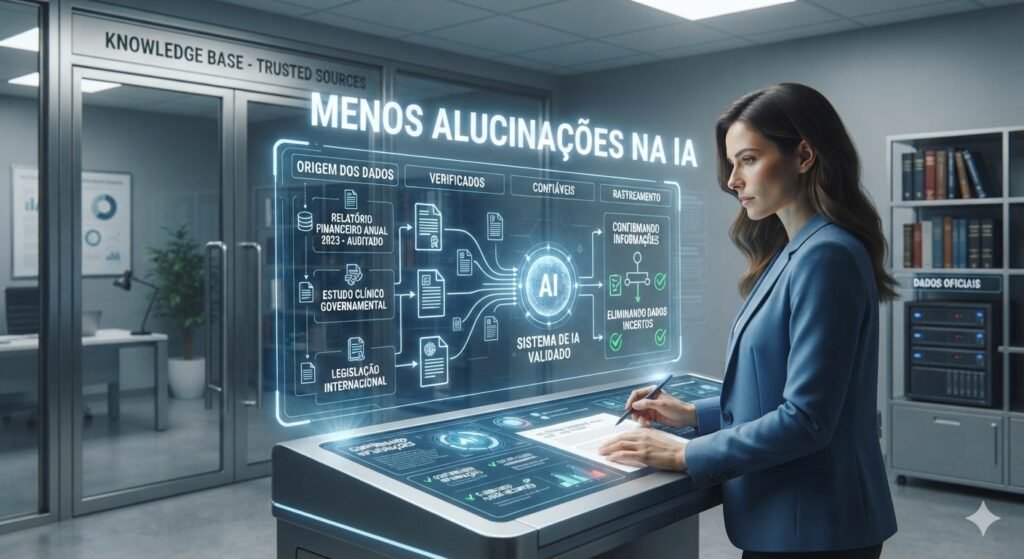
Um DSLM reduz esse risco justamente porque opera dentro de um espaço de conhecimento muito mais restrito e consistente. Ao ser treinado quase exclusivamente com dados verificados e específicos de um setor — jurisprudência real, prontuários reais, documentos regulatórios reais —, o modelo tem muito menos margem para “inventar” uma resposta plausível, mas incorreta, simplesmente porque o universo de possibilidades que ele aprendeu é mais estreito e mais bem delimitado. Isso não elimina completamente o risco de erro, mas reduz significativamente a margem de ambiguidade semântica que costuma gerar esse tipo de falha.
Onde os DSLMs já estão fazendo diferença
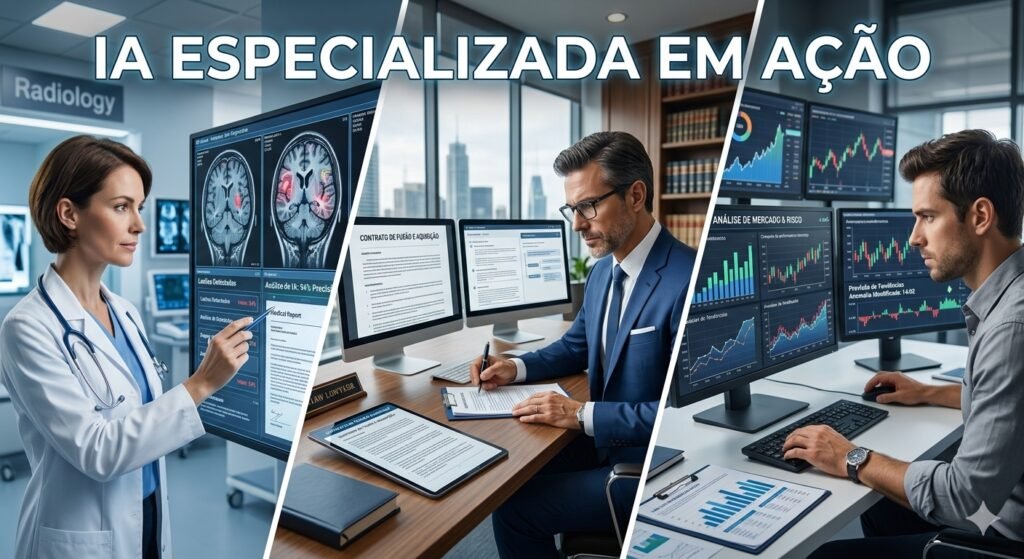
Medicina: diagnósticos mais alinhados à prática clínica real
Na área da saúde, modelos especializados já vêm sendo usados como apoio ao diagnóstico, ajudando profissionais a interpretar sintomas, cruzar protocolos clínicos e até analisar imagens médicas com mais contexto do que um modelo generalista conseguiria oferecer. Um modelo de visão treinado especificamente para interagir com radiologistas, por exemplo, consegue extrair conhecimento útil de exames de imagem de uma forma que um modelo de propósito geral simplesmente não foi desenhado para fazer, porque nunca foi exposto, em profundidade, a esse tipo específico de dado visual médico.
Isso também favorece o cumprimento de protocolos clínicos estabelecidos: como o modelo “conhece” as diretrizes daquele hospital, daquela rede de saúde ou daquela especialidade médica, a resposta tende a estar mais alinhada ao que, de fato, a prática recomenda, reduzindo a chance de uma sugestão genérica demais, desalinhada da realidade daquele contexto clínico específico.
Advocacia: contratos revisados em segundos
No setor jurídico, a promessa dos DSLMs é reduzir drasticamente o tempo gasto em tarefas repetitivas, porém sensíveis: revisão de contratos, análise de cláusulas de risco, comparação com legislação vigente. Um modelo treinado especificamente com jurisprudência, legislação e modelos de contrato de uma área específica do direito consegue identificar inconsistências, cláusulas fora do padrão ou riscos regulatórios com uma precisão que um modelo generalista — que só “ouviu falar” de direito de forma superficial durante seu treinamento amplo — simplesmente não tem condições de oferecer com a mesma confiabilidade.
Finanças: menos erro semântico em decisões de risco
No setor financeiro, a interpretação de documentos, políticas internas e classificações de risco depende de uma precisão semântica que erros de interpretação genérica podem comprometer seriamente. Um DSLM financeiro, treinado com dados proprietários daquela instituição — relatórios internos, políticas de crédito, históricos de operações —, consegue interpretar esse tipo de documento com uma aderência ao negócio que modelos generalistas, por definição, não têm, porque nunca foram expostos ao vocabulário e às particularidades regulatórias daquela instituição específica.
O papel dos dados proprietários: a verdadeira vantagem competitiva
Um ponto central para entender por que os DSLMs ganharam tanta força é que eles dependem diretamente dos dados proprietários de cada empresa ou setor — informações que, por definição, modelos generalistas treinados com dados públicos da internet simplesmente não têm acesso. Isso cria uma vantagem competitiva real: duas empresas do mesmo setor podem usar a mesma tecnologia de base de inteligência artificial, mas a empresa que treinar seu modelo com dados internos mais ricos, mais organizados e mais específicos vai obter respostas mais precisas e mais alinhadas à própria realidade de negócio do que a concorrente que depende apenas de um modelo genérico de mercado.
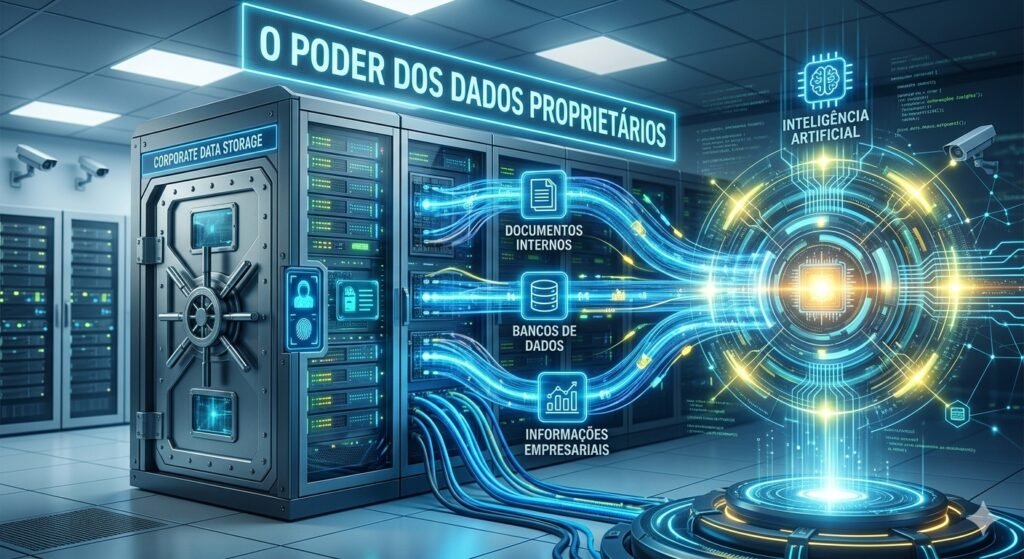
Isso também ajuda a resolver um problema prático recorrente em setores altamente regulados, como saúde, jurídico e finanças: muitos dos dados mais valiosos para treinar um modelo de IA nesses setores são sensíveis, proprietários ou protegidos por regras de privacidade, e simplesmente não estão disponíveis — nem deveriam estar — para treinar modelos generalistas de mercado usados por qualquer empresa do mundo. Um DSLM, construído internamente ou em parceria restrita, permite aproveitar esse tipo de dado sensível sem expô-lo a um modelo compartilhado externamente.
SLMs e DSLMs: parentes próximos, mas não idênticos
Vale um esclarecimento importante, porque os dois termos às vezes se confundem no mercado: SLM (Small Language Model, ou Modelo de Linguagem Pequeno) se refere ao tamanho do modelo — ou seja, à quantidade de parâmetros e à capacidade de processamento exigida —, enquanto DSLM se refere à especialização do conteúdo em que o modelo foi treinado. Na prática, a maioria dos DSLMs também costuma ser relativamente pequena em comparação aos grandes modelos generalistas, já que não precisam carregar conhecimento sobre praticamente todos os assuntos do mundo — mas o que define um DSLM é a profundidade e a especificidade dos dados usados, não apenas o tamanho do modelo em si.
Essa combinação, aliás, traz um benefício adicional pouco falado: modelos menores e mais especializados tendem a ser mais baratos de treinar, ajustar e operar no dia a dia do que os gigantescos modelos generalistas, que exigem uma quantidade imensa de poder computacional só para funcionar. Isso reduz custos operacionais para empresas que não precisam, de fato, de uma inteligência artificial capaz de discutir qualquer assunto do universo — precisam, isso sim, de uma inteligência artificial excelente dentro do próprio domínio de atuação.
Os desafios que ainda existem
Apesar das vantagens, migrar para DSLMs não é um processo simples nem isento de desafios:
- Qualidade dos dados de treinamento: um DSLM só é tão bom quanto os dados usados para treiná-lo. Se os dados internos de uma empresa forem desorganizados, incompletos ou desatualizados, o modelo especializado vai herdar exatamente essas falhas, em vez de corrigi-las.
- Escopo limitado: um DSLM bem treinado é excelente dentro do seu domínio específico, mas praticamente inútil fora dele — diferente de um LLM generalista, que consegue, ainda que com menos profundidade, responder sobre praticamente qualquer assunto.
- Investimento inicial: construir ou ajustar um modelo especializado, com curadoria cuidadosa de dados proprietários, exige investimento técnico e humano que nem toda empresa tem disponível de imediato, especialmente negócios de menor porte.
- Manutenção contínua: setores como saúde, direito e finanças têm regras e normas que mudam com frequência. Um DSLM precisa de atualização constante para continuar refletindo a legislação, os protocolos e as práticas mais recentes daquele setor, sob risco de ficar desatualizado silenciosamente.
Por que 2026 é apontado como o ano da virada
Diversas análises do setor de tecnologia já apontam 2026 como um ponto de inflexão na adoção empresarial de modelos especializados, argumentando que a maior parte das decisões dentro de uma empresa nasce de detalhes muito específicos daquele negócio — exatamente o tipo de nuance que um modelo generalista tem mais dificuldade de capturar com precisão. Esse movimento tende a colocar os DSLMs como protagonistas, especialmente em setores que “não podem errar”: finanças, saúde, seguros, indústria e áreas fortemente reguladas, onde cada decisão de IA precisa ser rastreável, explicável e alinhada a padrões rígidos de conformidade.
Isso não significa que os modelos generalistas vão desaparecer — eles continuam sendo extremamente úteis para tarefas amplas, criativas ou exploratórias, onde não existe um domínio técnico restrito o suficiente para justificar um modelo dedicado. O que muda é a forma como as empresas mais maduras em adoção de IA vêm pensando sua estratégia: em vez de perguntar “qual é o modelo mais poderoso disponível no mercado?”, a pergunta que ganha força é “qual é o modelo mais adequado para o problema específico que eu preciso resolver?”.
Como as empresas costumam construir um DSLM
Não existe um único caminho para se chegar a um modelo especializado, mas duas abordagens aparecem com mais frequência entre as empresas que já avançaram nessa transição:
- Ajuste fino (fine-tuning) de um modelo já existente: em vez de treinar uma rede neural inteira do zero, a empresa parte de um modelo generalista já consolidado no mercado e o “refina” com uma quantidade menor, porém altamente específica, de dados proprietários do próprio setor. Essa abordagem costuma ser mais rápida e mais barata, já que aproveita a base de linguagem já aprendida pelo modelo original.
- Treinamento dedicado desde o início: em cenários onde a sensibilidade dos dados ou a especificidade do domínio exige um controle muito maior sobre cada etapa do processo, algumas organizações optam por treinar um modelo inteiramente novo, usando exclusivamente dados do próprio domínio desde a primeira etapa de aprendizado. Essa abordagem exige muito mais investimento técnico, mas reduz ao máximo qualquer resíduo de conhecimento genérico que poderia introduzir ambiguidade indesejada nas respostas.
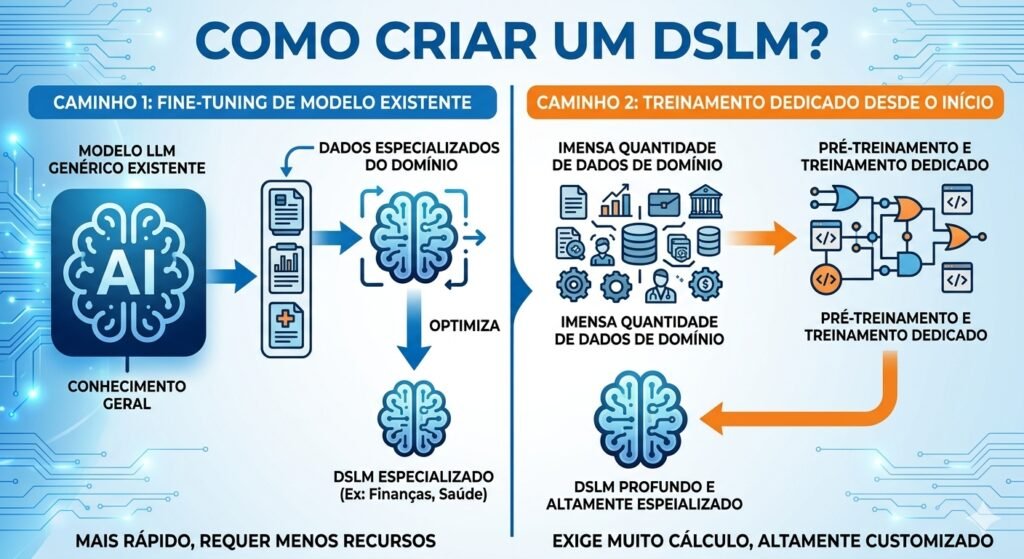
Em ambos os casos, a etapa mais trabalhosa costuma ser a organização e a curadoria dos dados internos: documentos espalhados em formatos diferentes, sistemas desconectados entre si e informações desatualizadas precisam ser organizados e validados antes de servirem como material de treinamento confiável — um trabalho que, segundo especialistas do setor, consome boa parte do tempo total de qualquer projeto de implementação de IA especializada.
Privacidade: uma vantagem que vai além da precisão
Além de reduzir erros, os DSLMs oferecem um benefício que se tornou cada vez mais relevante para empresas de setores regulados: manter dados sensíveis dentro do próprio ambiente controlado da organização, em vez de depender de modelos de terceiros hospedados externamente, que podem levantar dúvidas sobre como esses dados são processados, armazenados ou eventualmente reutilizados.
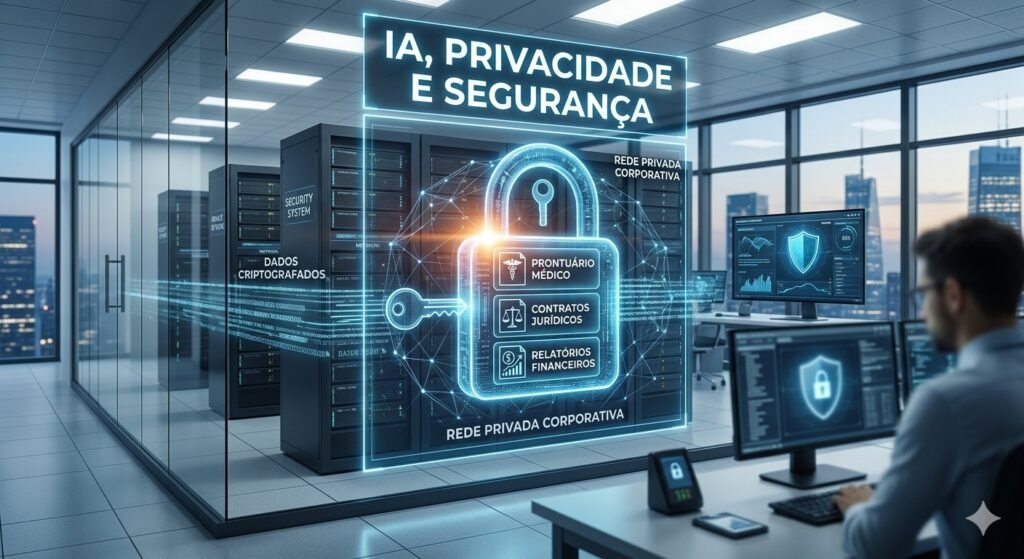
Para hospitais, escritórios de advocacia e instituições financeiras, essa diferença não é um detalhe técnico menor — é, muitas vezes, uma exigência regulatória direta. Legislações de proteção de dados, comuns em praticamente todos os países que regulam esses setores, costumam impor restrições severas sobre como informações sensíveis de pacientes, clientes ou processos judiciais podem ser tratadas por sistemas automatizados, o que torna o controle total sobre o próprio modelo de IA uma vantagem estratégica, e não apenas uma preferência técnica.
O que significa DSLM? É a sigla para Domain-Specific Language Model, ou Modelo de Linguagem Específico de Domínio — um tipo de inteligência artificial treinado especificamente com dados de um setor ou área de conhecimento, em vez de dados genéricos e variados da internet.
DSLMs são sempre menores que os LLMs generalistas? Na maioria dos casos, sim, já que não precisam carregar conhecimento amplo sobre todos os assuntos possíveis. Mas o que define um DSLM é a especialização dos dados de treinamento, não necessariamente o tamanho do modelo.
Por que os DSLMs reduzem as “alucinações” da inteligência artificial? Porque operam dentro de um universo de conhecimento muito mais restrito e consistente, treinado com dados verificados e específicos de um setor, o que reduz a chance de o modelo combinar informações de contextos diferentes de forma incorreta — uma das principais causas de respostas inventadas em modelos generalistas.
Empresas pequenas também conseguem usar DSLMs? Em teoria, sim, embora o investimento inicial em curadoria de dados e ajuste do modelo possa ser um obstáculo maior para negócios menores. Com o barateamento progressivo dessa tecnologia, a tendência é que esse tipo de solução se torne cada vez mais acessível também para empresas de menor porte.
Os modelos generalistas (LLMs) vão deixar de ser usados? É pouco provável. LLMs continuam sendo extremamente úteis para tarefas amplas, criativas e exploratórias. A tendência é que DSLMs e LLMs coexistam, cada um atendendo melhor a um tipo diferente de necessidade dentro das empresas.
Conclusão
A ascensão dos DSLMs representa uma mudança de mentalidade importante na forma como empresas encaram a inteligência artificial: o tamanho e a amplitude de um modelo deixaram de ser, isoladamente, sinônimo de qualidade. Em setores onde o erro tem um custo alto — um diagnóstico equivocado, uma cláusula contratual mal interpretada, uma decisão financeira baseada em dado incorreto —, a especialização profunda em um domínio específico se mostra mais valiosa do que a promessa de uma IA que “sabe um pouco de tudo”. O futuro da inteligência artificial corporativa, pelo menos nos setores mais sensíveis, parece caminhar menos para “qual é o modelo mais poderoso do mercado” e mais para “qual é o modelo mais bem treinado para o meu problema específico”.